当GPU集群的功耗和散热逼近物理极限,当摩尔定律的放缓让“堆更多晶体管”的旧逻辑越来越昂贵,AI算力的下一程增长,需要一条全新的技术路线。光计算,正是被寄予厚望的答案之一——它让光在传播中直接完成矩阵运算,速度和能效潜力远超电子方案。但过去几年,光计算始终面临一个核心质疑:能在实验室跑出惊人数据,却难以像GPU一样灵活适配不同模型和任务。上海一家名为智子光垣的初创公司,正在正面回应这个质疑。其团队打造的光计算芯片能实现150 TOPS算力,并即将推出面向服务器端和边缘端的两款可部署产品。更关键的是,智子光垣的目标不是做一颗“算得快的专用芯片”,而是构建一个可重构、可扩展的通用光计算平台——如果这条路走通,它颠覆的将不只是芯片架构,而是整个AI算力的供给方式。
电芯片正在逼近物理和能耗极限
AI越强,算力的代价就越高。更大的模型、更密集的推理,正在把芯片、供电、散热乃至整个数据中心推向新的极限。今天的问题已经不只是“还能造多少GPU”,而是现有计算方式还能不能支撑下一轮AI增长。
国际能源署预计,2025年至2030年,全球数据中心用电量将从485 TWh增至约950 TWh;其中,面向AI的数据中心用电量将增至约3倍,将导致严肃的AI能源问题。
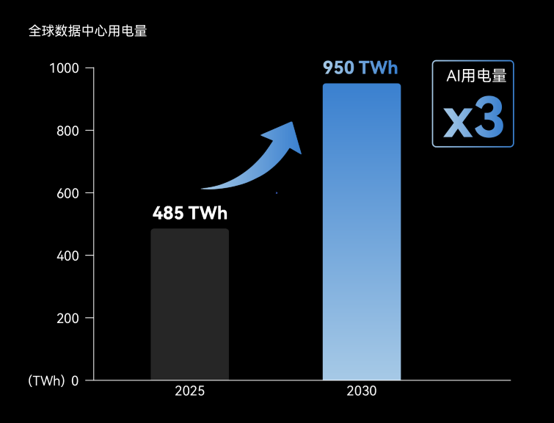
AI数据中心用电量
AI扩张带来的压力,正在从模型Token成本一路传导至算力基础设施紧缺以及电子芯片摩尔定律失效。
当电子计算越来越接近能效边界,一条新的路线正在加速走向产业化——光计算。
电的瓶颈,为什么光计算会是答案?
光的优势,不只在“快”。它可以蕴含海量信息,多路多维度并行,更重要的是,传播本身,就可以成为计算。
光天然存在干涉与衍射等物理效应。通过设计光路,调控不同光束之间的相互作用,完成光的振幅相位等信息叠加,矩阵运算便可以被写入光的传播过程中。而矩阵乘法,正是AI计算中最基础,也最密集的运算之一。
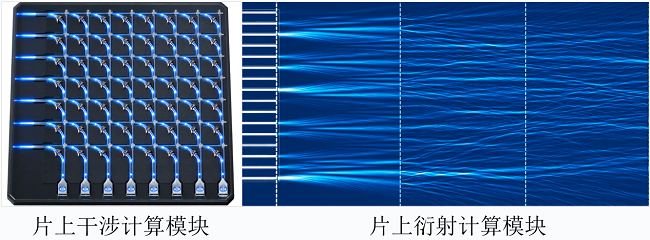
电子芯片需要晶体管不断开关、数据反复搬运,才能完成一次次乘加;而在光计算中,几束光从芯片的一端抵达另一端,大量乘加便可在光速传播中并行完成。
在大规模矩阵运算中,光子方案的速度潜力可达到电子方案的十万倍以上,单次运算能耗可降低一千倍以上,而所需要的芯片制程要求仅为电子的十分之一。
光计算芯片的价值,也正在于此。
但光能算,还不够
真正走向应用,还要回答另一个问题:
光能不能把一次运算中的优势,转化为真实系统可以调用的算力?
今天,光计算已经在特定运算中展现出速度与能效潜力。但从一次验证走向真实应用,面对的不再是单一、确定的计算条件:模型与任务会变化,计算规模需要扩展,芯片也要进入更加复杂的系统与运行环境。
真正的难题,是让光的优势在这些变化中依然成立。
从“能计算的光”,到“通用光计算”
面对这道问题,智子光垣选择了一条最贴近实际需求的路:推动光计算从“专用”走向“通用”。
所谓“通用”,并非让光包办所有计算,而是在光所擅长的范围内,让同一套硬件不被单一用途永久定义。
这套能力的起点,在计算核心的可重构。
智子光垣从芯片底层构建时空重构架构,使计算关系能够在空间与时间上完成同步调制。计算需求发生变化时,无需重新设计芯片,写进光路的计算关系即可随之重组。
当计算能够灵活重构,“通用”的下一步,是让算力随需求扩展。
干涉计算兼具高精度与灵活性,衍射计算擅长大规模并行。智子光垣通过chiplet将两者融入同一架构,单芯片级联多个光计算核心,使计算规模与可重构性持续提升。
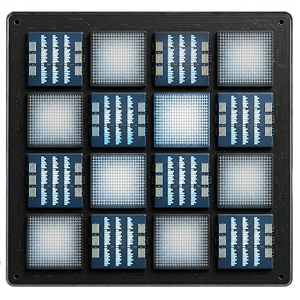
可重构:干涉*衍射*chiplet
同时,为了最大限度发挥光的优势,智子光垣推进“光传光算”,让通信光直接参与运算,并将关键的非线性处理留在光域,实现真正意义上光电转换~0的“全光”计算芯片。
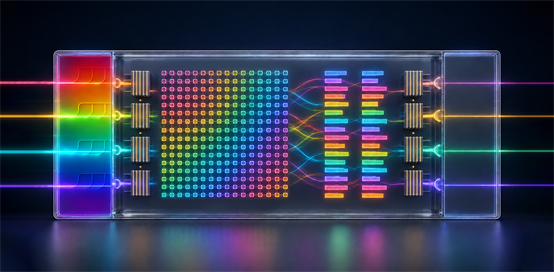
全光:光传光算*非线性
当然,真正的“通用”,不只存在于单颗样片,还要在批量生产的芯片上稳定复现。
为此,智子光垣通过软硬件补偿模块的协同设计,实现噪声温漂等纳秒级工程化校准,显著提升量产芯片的精度一致性。
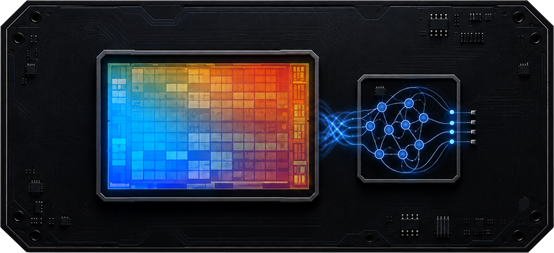
工程化:软硬件协同校准
从技术验证,到产品落地
基于前期芯片研发与工程验证成果,智子光垣计划在未来半年内陆续推出“烛龙”与“玄鉴”两款可部署的光计算产品。目前,相关芯片均已送流片。
其中,“烛龙 OPU-08”面向服务器端计算加速,聚焦AI推理中的大规模矩阵运算,以256×256计算核心、150 TOPS算力,为大模型云端部署提供“光子Token”;
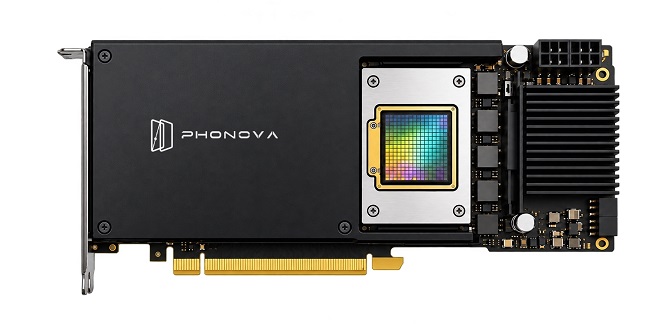
服务器光电加速卡-烛龙 OPU-08
“玄鉴 TOCU-07”面向边缘端低功耗智能设备,在真实物理世界完成大规模光电计算,同时其可摆脱光电编码,收集微弱自然环境光直接运算,以128×128计算核心、100 TOPS算力,完成端侧AI Infra的光子方案。
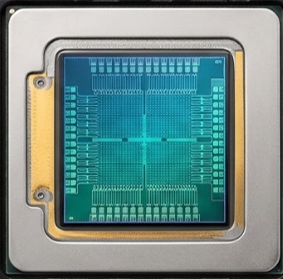
端侧光计算芯片-玄鉴 TOCU-07
未来,智子光垣还将进一步构建训推一体的光子“GPGPU”——把通用光计算能力集成为一套可扩展、可部署、能够承接不同模型与任务的光计算平台。
智子光垣:为下一代AI计算而来
智子光垣名字,承载着公司对下一代计算的构想。
“智子”取意于科幻作品《三体》中的高维科技,寓意承载高级智能的基本单元;“光垣”则寓意以光构建的算力疆垣。智子光垣,致力于突破传统计算边界,以可重构全光计算技术构建下一代通用算力基础设施。
要让这份愿景成为现实,既需要探索底层原理的研究能力,也需要把技术落地产品的工程能力。
智子光垣的技术路线发端于上海交通大学。发起人程远长期从事光子芯片与边缘智能研究,同时拥有大量芯片到产品的产业化经验。此前,他曾任端侧AI Infra领军企业辛米尔科技联创/CTO,主导搭建从芯片、模组到系统的全栈产品体系,并在多家世界500强企业实现大规模批量部署。
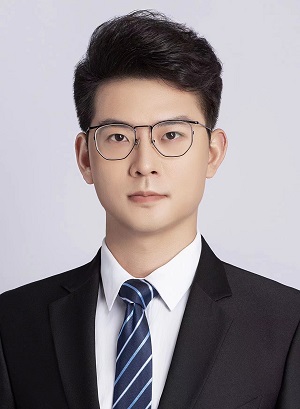
智子光垣发起人/上海交通大学 人工智能学院副教授 程远
公司团队多项光计算成果发表于Nature、Science系列封面文章等,累计完成数十款光芯片的设计、流片与验证。核心高管均为连续创业者,组建了一支覆盖AI模型、硅光芯片、集成电路、封装测试、系统工程的全链路产业化团队,致力于将光芯片的落地应用进程加快至少3年。
智子光垣自成立以来,已推动连续多轮融资,估值达数十亿,获主流资本市场认可,成为光计算芯片最头部的企业之一。这不仅体现了市场对通用光计算方向的信心,也意味着智子光垣成为这一赛道的核心玩家。
让计算,迎来下一束光
专用,是光计算走向应用的第一步;通用,是光计算成为算力基础设施的下一步。
智子光垣要做的,不是在某一次测试中把光算得更快,而是建立一种可重构、可扩展、可量产、可长期运行的通用光计算能力,让AI能够更方便地“调用”光。
当光真正成为通用算力,计算,也将迎来下一束光。
推荐阅读: